
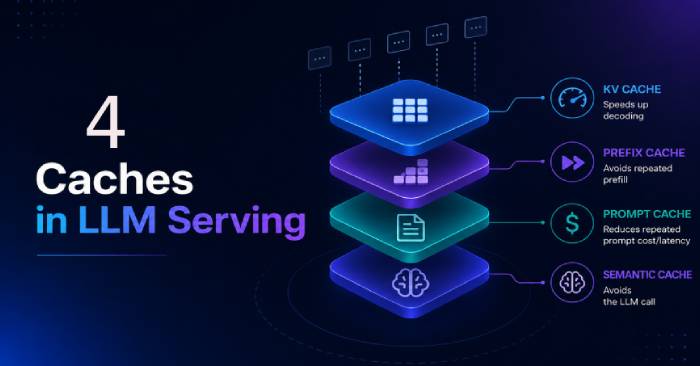
Bạn có bao giờ thắc mắc tại sao phản hồi từ chatbot AI ngày càng nhanh hơn? Một phần lý do nằm ở cách chúng "ghi nhớ" những thông tin đã xử lý. Khi mỗi yêu cầu có thể chứa hàng triệu token — từ hướng dẫn, lịch sử chat, đến tài liệu tham khảo — việc xử lý lại lặp lại cùng một dữ liệu là lãng phí cả thời gian lẫn năng lượng.
Thay vì phải "suy nghĩ lại" từ đầu, các hệ thống LLM hiện đại sử dụng nhiều loại bộ đệm khác nhau để tối ưu hóa. Mỗi loại hoạt động ở các giai đoạn khác nhau và giải quyết vấn đề riêng biệt. Điều thú vị ở đây là chúng không cạnh tranh mà thực sự bổ sung cho nhau.
4 loại bộ đệm mà bạn cần biết
1. KV Cache: Trái tim của mỗi phản hồi AI
Khi LLM tạo phản hồi, nó không xuất ra toàn bộ câu cùng một lúc. Thay vào đó, nó tạo từng token một — một từ hoặc từng phần của từ. Quá trình này gọi là "giải mã tự hồi quy".
Vấn đề thực sự nằm ở đây: ở mỗi bước, mô hình cần nhớ tất cả những gì nó đã "thấy" trước đó để tạo từ tiếp theo hợp lý. Bình thường, nó phải tính toán lại các trạng thái này từ đầu — cực kỳ tốn thời gian.
KV cache giải quyết bằng cách lưu trữ những "trạng thái" này (gọi là Key và Value) lại vào bộ nhớ. Lần sau, thay vì tính toán lại, mô hình chỉ cần lấy ra và sử dụng lại — nhanh gấp nhiều lần.
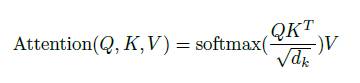
2. Prefix Cache: Khi ai đó hỏi cùng một câu
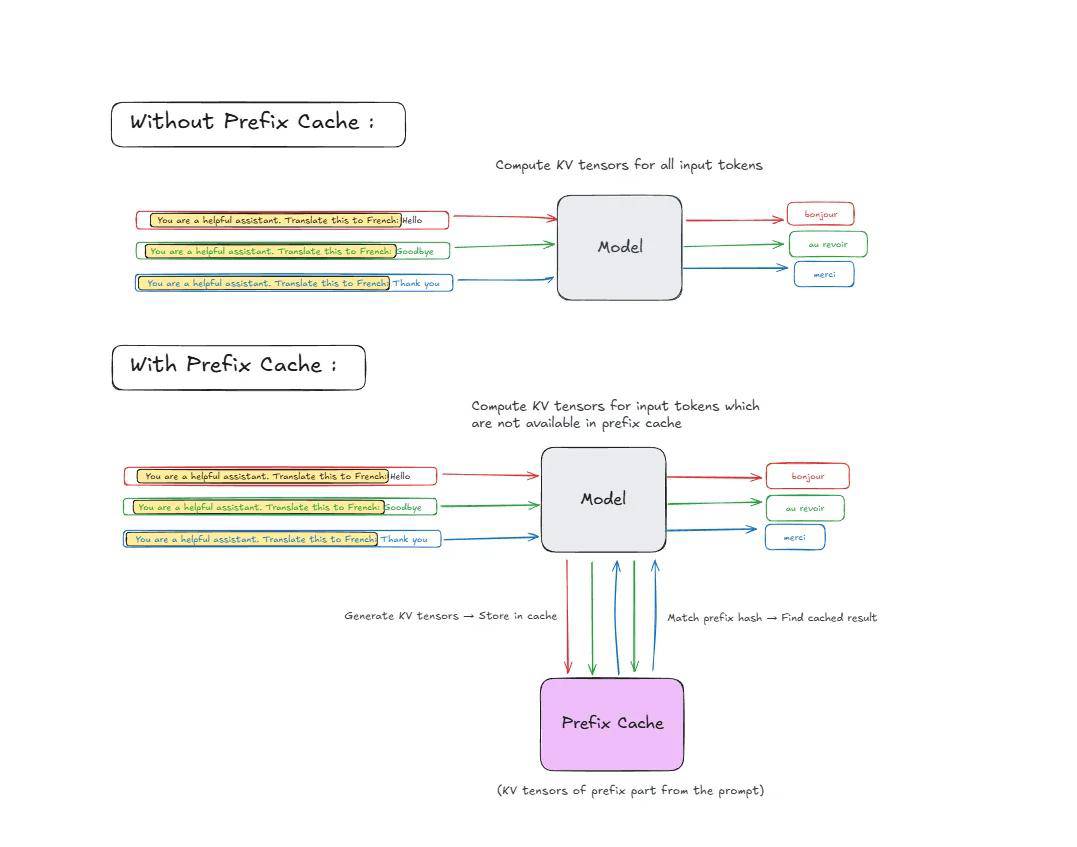
Tưởng tượng hàng ngàn người dùng gửi câu hỏi, nhưng tất cả đều bắt đầu bằng cùng một hướng dẫn hệ thống dài dòng. Chính sách công ty, tài liệu hướng dẫn, công cụ khả dụng — phần này giống nhau trong mọi yêu cầu.
Prefix cache cho phép hệ thống tái sử dụng các tính toán từ phần "tiền tố" chung này thay vì xử lý lại mỗi lần. Kết quả? Mỗi người dùng mới không cần chờ đợi xử lý toàn bộ phần hướng dẫn lại.
3. Prompt Cache: Khi bạn sử dụng ChatGPT hay Claude
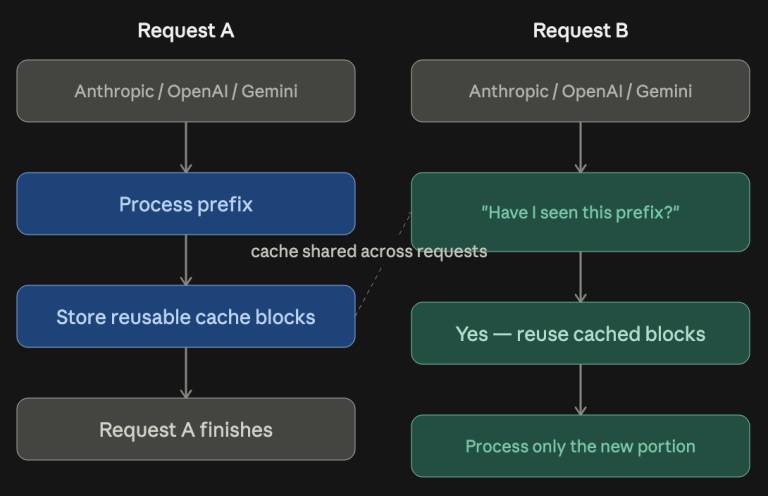
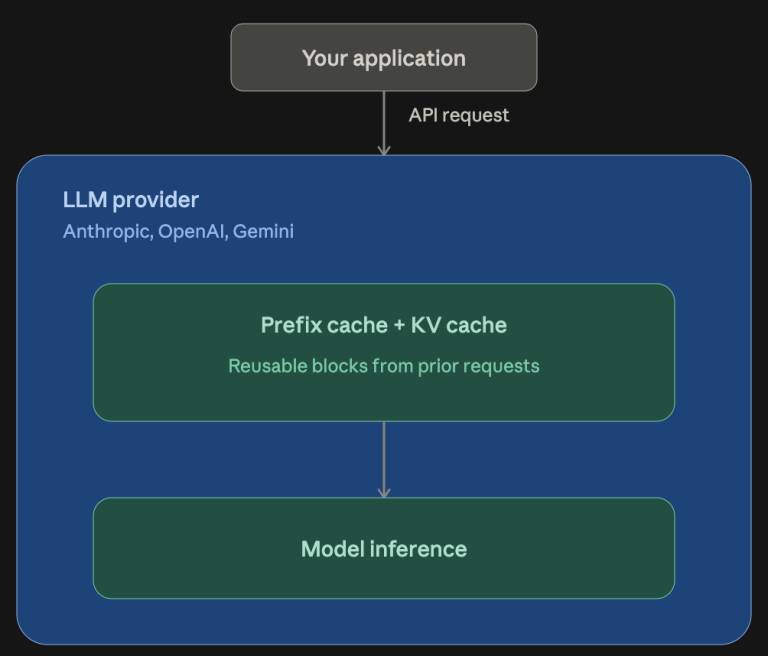
Nếu bạn không tự chạy mô hình mà dùng qua API của OpenAI, Google hay Anthropic, điều gì xảy ra? Nhà cung cấp có cơ chế riêng gọi là prompt caching.
Ứng dụng của bạn gửi một prompt khổng lồ (có thể chứa hàng chục nghìn token) lên. Khi câu hỏi thay đổi nhưng prompt vẫn như cũ, nhà cung cấp có thể tái sử dụng trạng thái đã xử lý. Bạn còn được lợi tiền nữa — đọc từ cache rẻ hơn ghi vào cache rất nhiều.
| Nhà cung cấp | Mô hình | Đọc từ cache | Ghi vào cache |
|---|---|---|---|
| OpenAI | GPT-4o | 0.1x | 1.25x |
| Anthropic | Claude 3.5 Sonnet | 0.1x | 1.25x |
| Gemini 2.0 Pro | 0.1x + phí lưu | 1x + phí lưu | |
| DeepSeek | DeepSeek V3 | 0.008x | 1x (tự động) |
Lưu ý: các nhà cung cấp có chính sách khác nhau về thời gian lưu cache và yêu cầu kích thước token tối thiểu.
4. Semantic Cache: Tìm câu trả lời thay vì hỏi lại
Ba loại cache trên tập trung vào việc "không phải xử lý lại". Semantic cache có suy nghĩ khác: "Có phải tôi đã trả lời câu hỏi này rồi không?"
Giả sử người dùng A hỏi: "Thủ đô của Pháp là gì?" → Nhận câu trả lời: "Paris". Sau đó, người dùng B hỏi: "Thành phố nào là thủ đô của Pháp?"
Hai câu hỏi khác nhau về từng chữ, nhưng ý nghĩa giống hệt. Semantic cache chuyển câu hỏi thành một "vector" (con số đại diện ý nghĩa) rồi so sánh với các câu hỏi trước. Nếu đủ giống, nó trả luôn câu trả lời cũ mà không cần gọi LLM.
Điều mạnh nhất ở semantic cache là nó có thể loại bỏ hoàn toàn một yêu cầu suy luận. Tuy nhiên, cần cẩn trọng — câu hỏi "Doanh thu Apple là bao nhiêu?" và "Doanh thu Apple năm 2025 là bao nhiêu?" rất tương đồng nhưng cần câu trả lời khác nhau. Ngưỡng độ tương đồng cần được thiết lập cẩn thận.
Chúng làm việc cùng nhau như thế nào?
Những loại cache này không "tranh nhau". Thay vào đó, chúng hoạt động theo tầng.
Khi một yêu cầu đến: trước tiên kiểm tra semantic cache (có câu trả lời giống này rồi không?). Nếu không, gửi đến mô hình nhưng tái sử dụng prefix cache cho phần hướng dẫn lặp lại. Khi mô hình tạo phản hồi, KV cache đảm bảo quá trình giải mã nhanh chóng.
Cách bạn kết hợp chúng tùy thuộc vào hệ thống và nhà cung cấp dùng. Điều quan trọng: nhiều loại cache có thể tồn tại cùng lúc, mỗi cái giải quyết một vấn đề riêng.
Description: Khám phá 4 loại cache khác nhau giúp mô hình ngôn ngữ LLM xử lý nhanh hơn, tiết kiệm chi phí và giảm độ trễ.
Related Articles
- ChatGPT dùng tiếng gì cũng được - Hướng dẫn đổi ngôn ngữ đơn giản
- Những công cụ AI tốt nhất giúp lập kế hoạch học tập hiệu quả năm 2026
- Những công cụ AI tạo video tốt nhất để thay thế Seedance hiện nay
- Biến Sơ Đồ Tư Duy Thành Video Động Trên Gemini - Hướng Dẫn Chi Tiết
- Cách Viết Yêu Cầu Cho Claude Design Để Có Kết Quả Tốt Nhất
